

Kimi K3 réussit 26,7 % des missions juridiques autonomes du benchmark Harvey LAB-AA, contre 14,2 % pour Claude Fable 5, selon l'instantané du classement Artificial Analysis du 21 juillet 2026. Cet écart spectaculaire cache une réalité plus utile pour votre pratique : les deux modèles satisfont quasiment le même nombre de critères (94,6 % contre 93,6 %), et ce qui les sépare est la capacité à ne rien oublier sur une mission complète.
Cet article vous donne les chiffres vérifiés et leurs sources, une explication simple de ce que le benchmark mesure vraiment, puis une méthode en cinq étapes pour tester ces agents sur vos propres dossiers, avec grilles à recopier, trois cas complets et une checklist de mise en service.
La réponse en 30 secondes
- Kimi K3 réussit 26,7 % des 120 missions de Harvey LAB-AA intégralement, Claude Fable 5 14,2 %, soit environ 32 dossiers contre 17 dans le classement Artificial Analysis du 21 juillet 2026.
- Sur les critères individuels, l'écart n'est que de 1,1 point : 94,64 % contre 93,56 %. Kimi ne sait pas deux fois plus de droit, il oublie moins souvent une exigence en route.
- Le classement dépend du harnais de test : sur l'implémentation indépendante de Vals AI (août 2026), Muse Spark 1.1 arrive en tête et Kimi K3 n'est que quatrième. Aucun classement ne remplace un test sur vos dossiers.
- Kimi K3 est lent (environ 44 minutes par mission) mais moins cher que Fable 5 dans cette évaluation (environ 12 dollars contre 19 dollars par mission).
- Même le leader échoue sur 73,3 % des missions : aucun agent juridique ne travaille seul aujourd'hui, la supervision humaine reste la règle.
- Le bon usage immédiat : préparation supervisée (premières versions, revue documentaire, détection de clauses), jamais de décision ni d'envoi sans validation.
- Vous pouvez reproduire la méthode du benchmark dans votre structure en un à deux jours de test : 20 à 30 dossiers types, une grille de critères, deux scores mesurés.
Ce que disent les chiffres
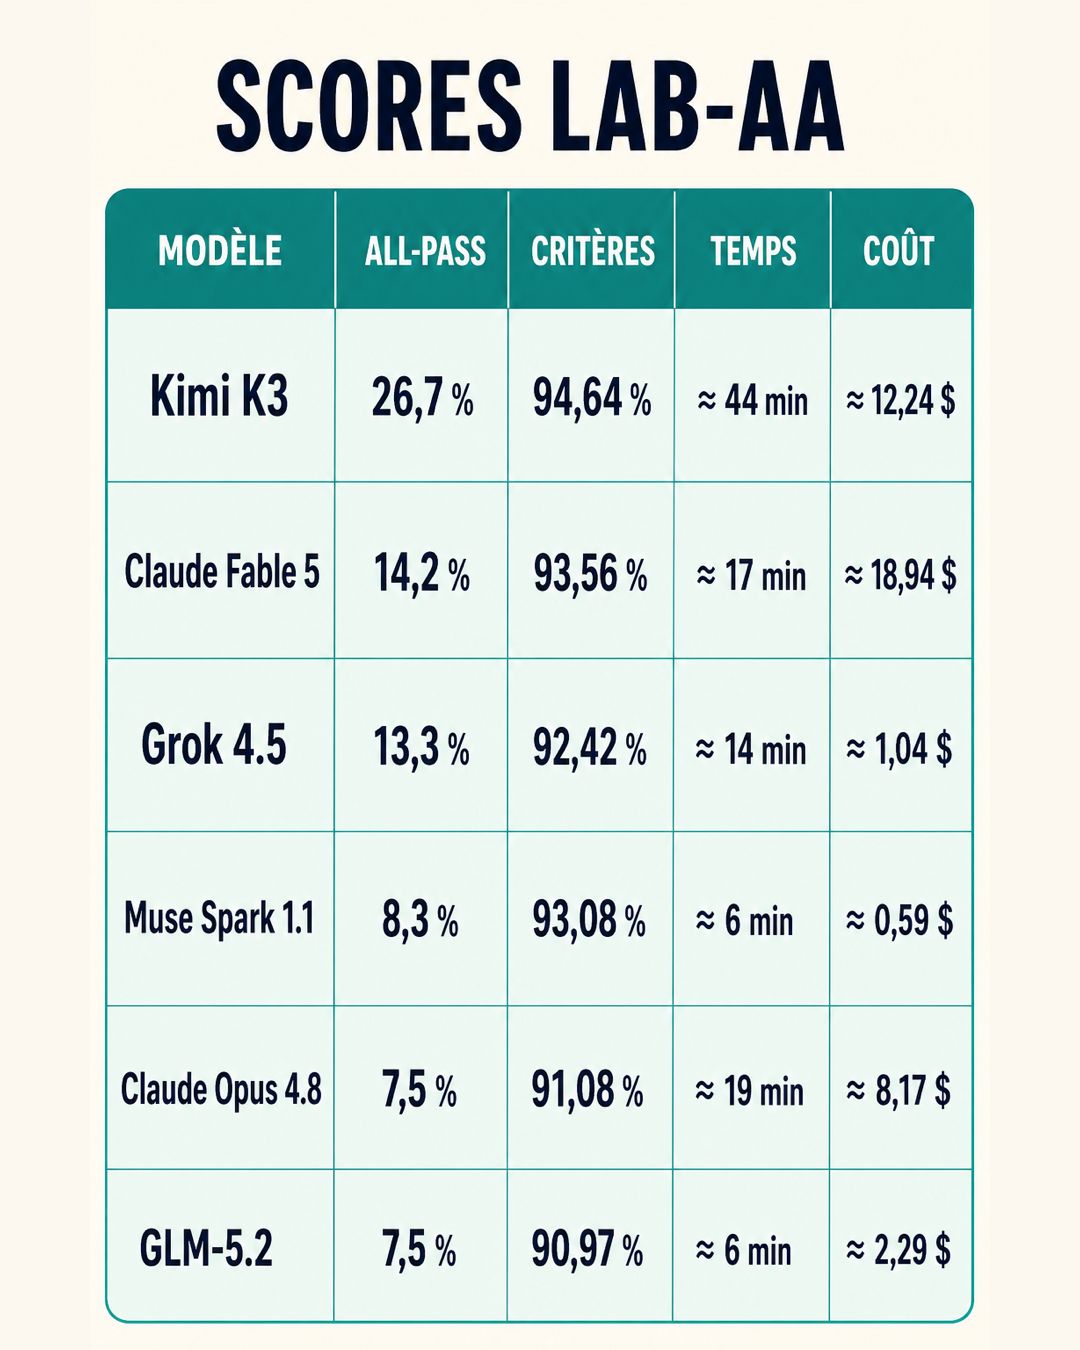
Harvey, la plateforme d'IA juridique, a publié en mai 2026 son Legal Agent Benchmark (LAB) : plus de 1 200 tâches dans 24 domaines de pratique, notées par plus de 75 000 critères rédigés par des juristes (Harvey, 6 mai 2026). Artificial Analysis en a repris un sous-ensemble privé de 120 missions pour son classement Harvey LAB-AA, dont voici l'instantané du 21 juillet 2026 (Artificial Analysis) :
| Modèle | Missions intégralement réussies | Critères satisfaits | Temps moyen | Coût moyen par mission |
|---|---|---|---|---|
| Kimi K3 | 26,7 % | 94,64 % | ≈ 44 min | ≈ 12,24 $ |
| Claude Fable 5 | 14,2 % | 93,56 % | ≈ 17 min | ≈ 18,94 $ |
| Grok 4.5 | 13,3 % | 92,42 % | ≈ 14 min | ≈ 1,04 $ |
| Muse Spark 1.1 | 8,3 % | 93,08 % | ≈ 6 min | ≈ 0,59 $ |
| Claude Opus 4.8 | 7,5 % | 91,08 % | ≈ 19 min | ≈ 8,17 $ |
| GLM-5.2 | 7,5 % | 90,97 % | ≈ 6 min | ≈ 2,29 $ |
Trois lectures s'imposent.
Un écart de complétude, pas de connaissance. Dans le classement Artificial Analysis, Kimi K3 ne produit pas deux fois plus de réponses juridiquement correctes : il satisfait 94,64 % des critères, contre 93,56 % pour Fable 5. Mais une mission n'est comptée réussie que si tous ses critères passent, sans crédit partiel. Sur des missions comptant en médiane 56 critères, un petit avantage moyen se transforme en gros écart de missions bouclées.
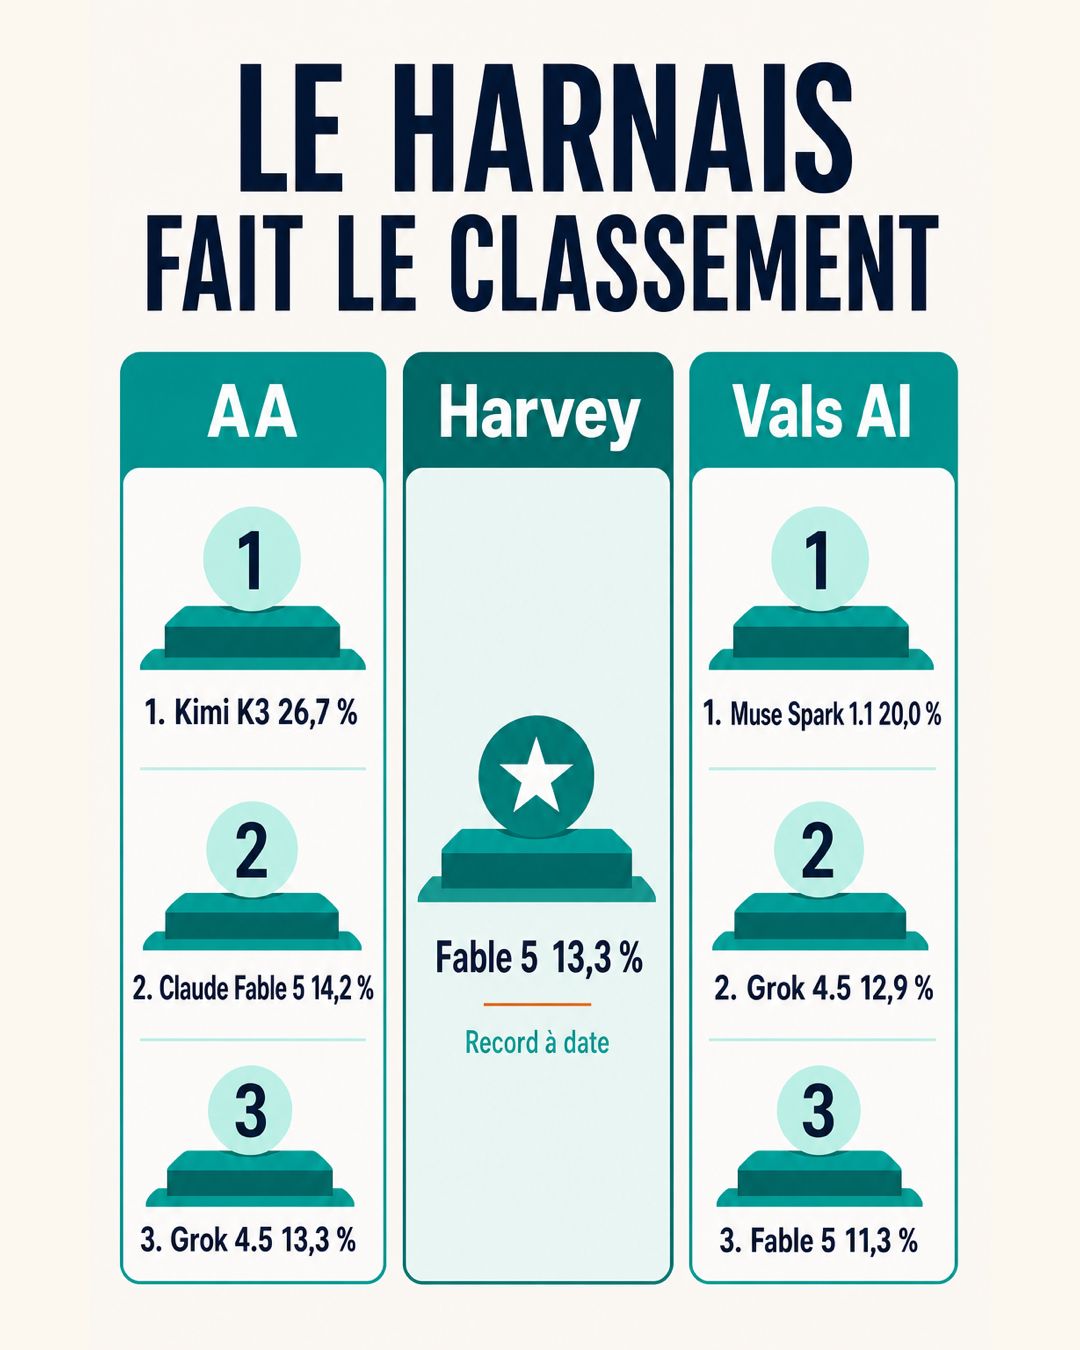
Le classement bouge selon le harnais. Chez Harvey lui-même, Fable 5 annonçait 13,3 % en juin 2026, un record à cette date (Harvey, 9 juin 2026). Sur l'implémentation indépendante de Vals AI publiée en août 2026, Muse Spark 1.1 mène à 20,0 %, devant Grok 4.5 (12,9 %), Fable 5 (11,3 %) et Kimi K3 (10,8 %) (Vals AI). Trois implémentations sérieuses, trois podiums différents. Retenez la méthode, pas le podium.
Le temps est le vrai prix de la complétude. Kimi K3 passe environ 44 minutes et 94 tours d'action par mission, contre 17 minutes et 64 tours pour Fable 5. Pour une revue de plusieurs heures, ce délai peut rester acceptable. Pour un usage interactif, il peut être trop long.
Ce que le benchmark mesure vraiment
Oubliez l'image du chatbot à qui l'on pose une question de droit. Une mission LAB ressemble à une note de service d'associé à un collaborateur : une cinquantaine de mots, un dossier de pièces en lecture seule (contrats, mails, tableurs, rapports annuels, dont certaines sont des leurres), et un livrable précis à produire, par exemple un fichier coc-analysis-report.docx sur les clauses de changement de contrôle d'une cible.
L'agent travaille seul, sans Internet, sans poser de question, avec un maximum de 200 tours d'action. Il est ensuite noté critère par critère : clause identifiée ou non, bonne section citée ou non, recommandation présente ou non, fichier produit au bon nom ou non.
Le benchmark reproduit une difficulté fréquente de la pratique : un livrable peut devenir inutilisable à cause d'un seul oubli décisif. Le benchmark mesure la fiabilité de la chaîne complète, pas la culture juridique.
La méthode : tester ces agents sur vos dossiers en cinq étapes
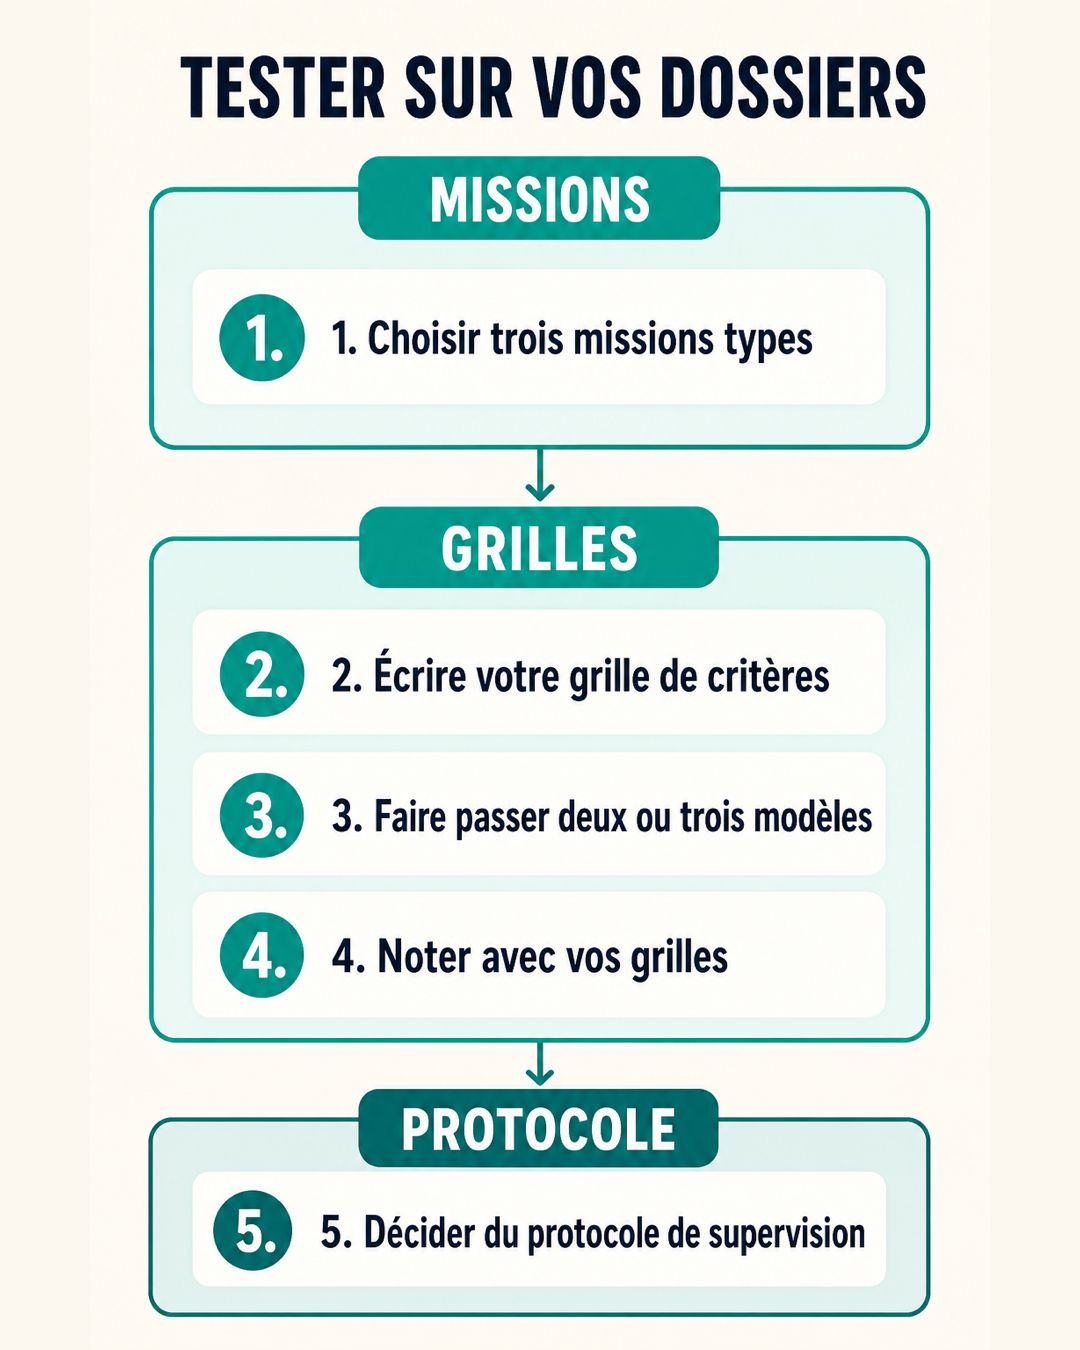
Étape 1 : choisir trois missions types (1 heure)
Prenez trois tâches réelles, fréquentes et vérifiables de votre pratique : une revue de clauses de changement de contrôle sur une data room, une synthèse de bail commercial, une revue de convention d'arbitrage. Exigez pour chacune un livrable précis : une note d'une page, un tableau de clauses, un mémo structuré. Anonymisez les pièces avant tout test vers une API externe : c'est une exigence de secret professionnel, et les recommandations de la CNIL sur l'IA, consultées le 6 août 2026 encadrent précisément ces traitements.
Étape 2 : écrire votre grille de critères (2 heures)
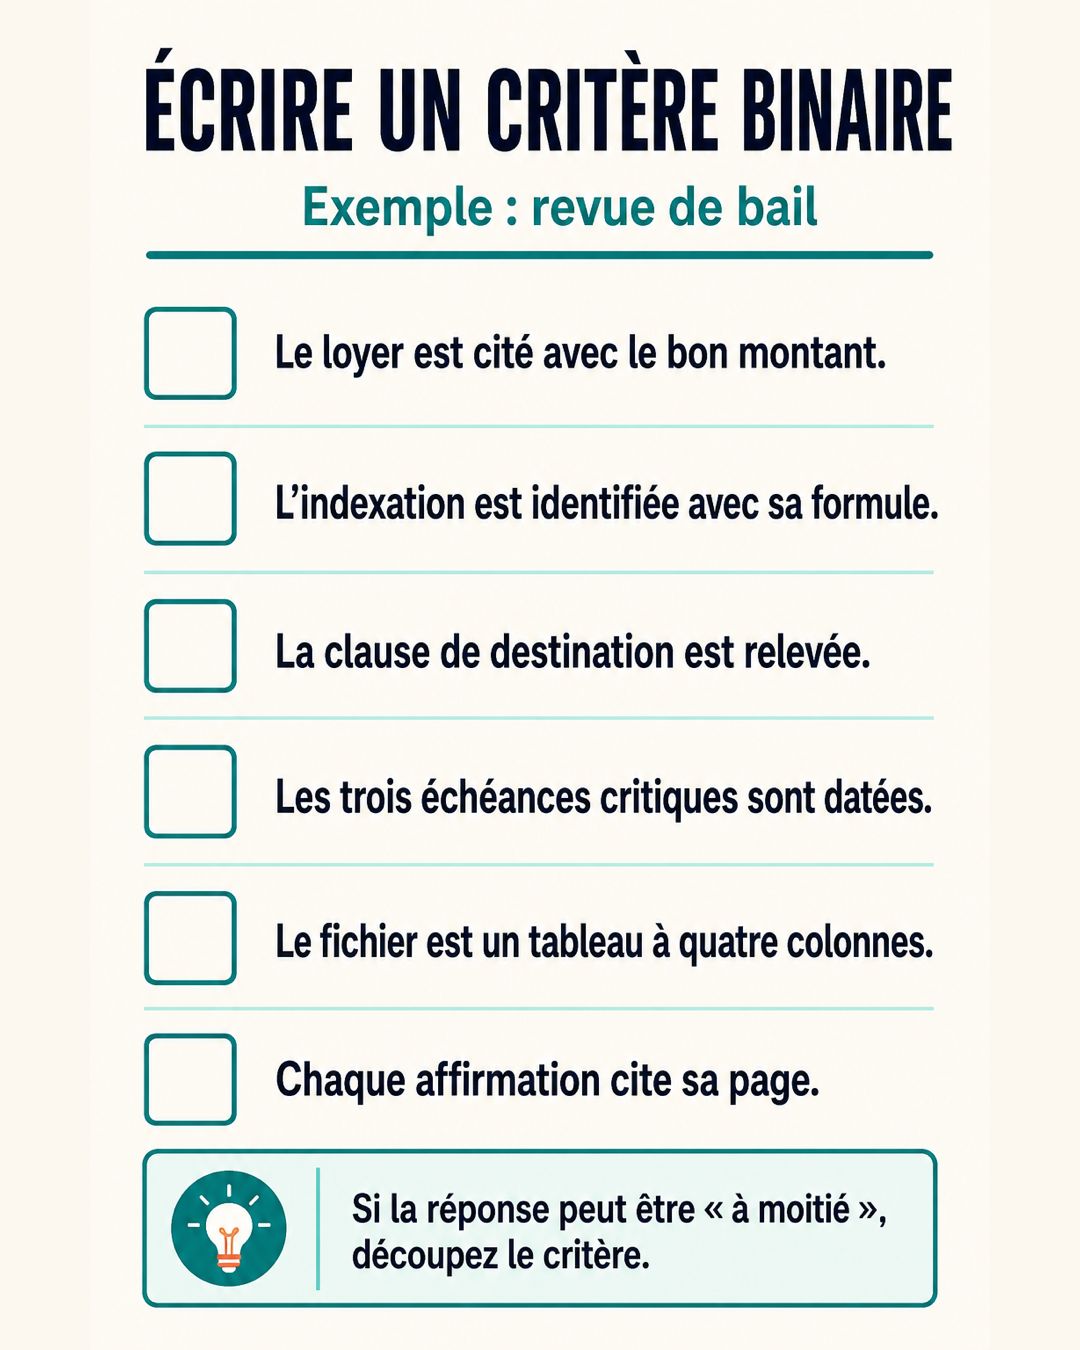
C'est le cœur de la méthode LAB, et c'est copiable tel quel. Pour chaque mission, listez 15 à 30 critères binaires : ce que le livrable doit contenir, sans nuance.
Exemple pour une revue de bail : le loyer est cité avec le bon montant ; l'indexation est identifiée avec sa formule ; la clause de destination est relevée ; les trois échéances critiques sont datées ; le fichier est un tableau à quatre colonnes ; chaque affirmation cite sa page.
Si un critère peut recevoir la réponse « à moitié », découpez-le en deux critères.
Étape 3 : faire passer deux ou trois modèles (une demi-journée)
Soumettez exactement la même consigne et les mêmes pièces à deux ou trois modèles, dans leurs versions API ou leurs interfaces agentiques. Notez le temps, et si vous utilisez l'API, le coût en tokens. Ne changez rien d'un modèle à l'autre : c'est la règle qui rend la comparaison honnête, et c'est aussi pour cela que les trois implémentations du benchmark donnent des classements différents.
Étape 4 : noter avec vos grilles (2 heures)
Un juriste coche les critères, sans savoir quel modèle a produit quoi si possible. Calculez deux scores, comme le benchmark : le taux de critères satisfaits (la qualité moyenne) et le taux de missions intégralement réussies (la fiabilité). C'est le second qui décide si un agent peut préparer un dossier sans y laisser d'oubli silencieux.
Étape 5 : décider du protocole de supervision (1 heure)
Pour chaque usage retenu, écrivez noir sur blanc : ce que l'agent prépare, ce que l'humain vérifie, ce qui est interdit à l'agent (envoi au client, conclusion définitive, suppression de pièce), et où sont stockées les données. C'est ce protocole, pas le choix du modèle, qui engage votre responsabilité.
Trois cas complets
Les cas suivants sont des schémas types de déploiement, pas des résultats clients.
Cas 1 : le cabinet M&A de 15 avocats. Problème : chaque due diligence mobilise deux collaborateurs pendant une semaine sur la revue des clauses de changement de contrôle. Mise en oeuvre : l'agent produit un tableau des clauses avec citations de pages, un collaborateur vérifie chaque ligne contre les pièces, l'associé relit la synthèse. Ce que le benchmark apprend : choisir le modèle sur la complétude mesurée sur vos propres data rooms de test, pas sur le classement public, et conserver la vérification ligne à ligne tant que toutes les missions ne sont pas intégralement réussies.
Cas 2 : la direction juridique d'une ETI. Problème : 400 contrats fournisseurs à re-vérifier après une évolution réglementaire. Mise en oeuvre : un modèle économique et rapide extrait les clauses concernées, un modèle plus complet repasse uniquement sur les dossiers signalés, puis le juriste valide les dossiers à enjeu. Le benchmark Artificial Analysis montre que le coût API varie selon le modèle ; mesurez sur vos volumes la part envoyée au second étage et le temps de revue humaine. Le critère de tri doit être écrit avant de lancer.
Cas 3 : le juriste unique d'une PME. Problème : pas le temps de lire chaque avenant en première intention. Mise en oeuvre : l'agent produit une fiche d'une page par avenant (objet, échéances, pénalités, points d'attention), le juriste vérifie ces points sur la pièce originale. Le benchmark Artificial Analysis rappelle qu'une fiche peut manquer un élément : le gain de première lecture doit donc être mesuré sur vos dossiers, avec citations de pages et validation humaine.
Les erreurs fréquentes
Changer de modèle à chaque classement. Trois implémentations du même benchmark donnent trois podiums. Un classement est une photo d'un harnais, pas une vérité sur vos dossiers.
Confondre qualité moyenne et fiabilité. Un score de 94 % de critères satisfaits dans le benchmark peut donner un livrable qui paraît excellent tout en manquant la clause décisive. Mesurez le taux de missions intégralement réussies.
Envoyer des pièces nominatives vers une API sans cadre. Secret professionnel, recommandations CNIL, règles déontologiques : l'anonymisation et le contrat avec le fournisseur précèdent le premier test.
Supprimer la relecture parce que le score est bon. Même le leader échoue sur près de trois missions sur quatre. La relecture n'est pas un manque de confiance, c'est le design du système.
Tester sur des questions de droit plutôt que sur des livrables. Une bonne réponse à « qu'est-ce qu'une clause de changement de contrôle » ne dit rien de la capacité à produire votre note de 12 pages. Testez le livrable, pas la culture.
Checklist avant mise en service
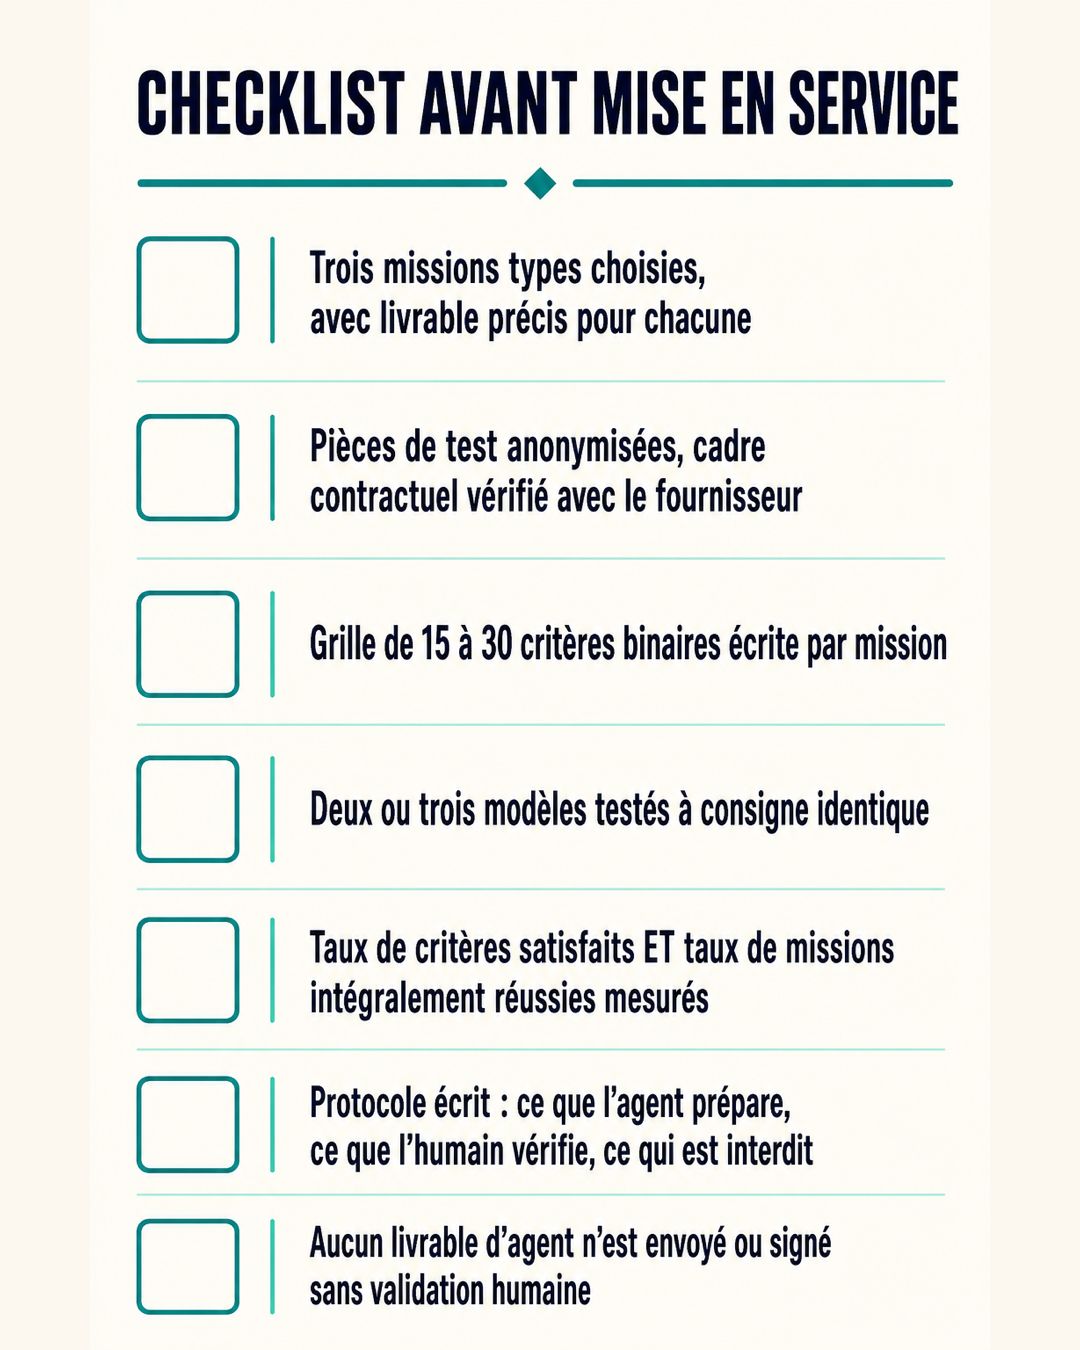
- ☐ Trois missions types choisies, avec livrable précis pour chacune
- ☐ Pièces de test anonymisées, cadre contractuel vérifié avec le fournisseur
- ☐ Grille de 15 à 30 critères binaires écrite par mission
- ☐ Deux ou trois modèles testés à consigne identique
- ☐ Taux de critères satisfaits ET taux de missions intégralement réussies mesurés
- ☐ Protocole écrit : ce que l'agent prépare, ce que l'humain vérifie, ce qui est interdit
- ☐ Règle absolue rappelée à l'équipe : aucun livrable d'agent n'est envoyé ou signé sans validation humaine
Conclusion
Le signal de cet été 2026 n'est pas « Kimi remplace Claude ». C'est que la complétude d'un dossier juridique devient mesurable, et que sur l'implémentation LAB-AA d'Artificial Analysis, Kimi K3 boucle environ une mission sur quatre sans critère manquant. La bonne réponse n'est ni l'enthousiasme ni le mépris : c'est un à deux jours de test sur vos propres dossiers, une grille de critères, et un protocole de supervision écrit. Si vous voulez installer cette méthode avec vos équipes, c'est exactement l'objet de nos formations IA pour les fonctions juridiques et de notre formation IA responsable et conformité. Pour choisir vos outils plus largement, voir notre comparatif ChatGPT, Claude et Gemini en entreprise et notre guide sur les agents IA en entreprise.
FAQ
Kimi K3 est-il vraiment meilleur que Claude Fable 5 en droit ?
Sur l'implémentation Harvey LAB-AA d'Artificial Analysis, instantané du 21 juillet 2026, Kimi K3 réussit 26,7 % des missions intégralement, contre 14,2 % pour Claude Fable 5. Mais sur les critères individuels, l'écart n'est que de 1,1 point, et sur l'implémentation indépendante de Vals AI, c'est Muse Spark 1.1 qui arrive en tête en août 2026. Le bon réflexe n'est pas de changer de modèle sur un classement, mais de tester les modèles sur vos propres dossiers.
Un agent IA peut-il travailler seul sur un dossier juridique en 2026 ?
Non. Dans l'instantané Artificial Analysis, même le meilleur modèle laisse au moins un critère non satisfait dans 73,3 % des missions. Le bon usage est la préparation supervisée : première version, revue documentaire, détection de clauses, tableau de synthèse, avec validation humaine systématique.
Que risque un avocat qui utilise un agent IA sans protocole ?
Trois risques : une omission que personne ne vérifie, une violation du secret professionnel si les documents partent vers une API sans cadre contractuel, et une responsabilité engagée sur un livrable non contrôlé. Les recommandations de la CNIL et les règles déontologiques imposent un cadre : outil encadré, données maîtrisées, contrôle humain documenté.
Comment tester un agent IA juridique avant de le déployer ?
Constituez 20 à 30 missions réelles anonymisées, écrivez pour chacune une grille de critères binaires, faites passer deux ou trois modèles à consigne identique, et mesurez le taux de critères satisfaits et le taux de missions intégralement réussies. C'est la méthode LAB de Harvey, appliquée à votre structure.
Combien coûte l'utilisation d'un agent IA sur un dossier juridique ?
Le classement Artificial Analysis publie un coût API moyen par mission pour chaque modèle. Ces montants évoluent et ne couvrent ni le temps de revue humaine, ni l'intégration, ni la conformité : relevez-les à la date du test et calculez votre coût complet.
Faut-il former les juristes à ces agents, et comment ?
Oui, et la formation porte sur la méthode, pas sur l'outil : écrire une consigne complète, construire une grille de vérification, lire une production d'agent en cherchant ce qui manque. Une journée de pratique sur vos dossiers types peut lancer l'apprentissage ; les réflexes doivent ensuite être vérifiés en situation. Voir nos formations.
Sources
- Artificial Analysis, Harvey LAB-AA Leaderboard, instantané du 21 juillet 2026
- Harvey, Introducing Harvey's Legal Agent Benchmark, 6 mai 2026
- Harvey, Anthropic Fable 5 Now Available, 9 juin 2026
- Vals AI, Harvey's Legal Agent Benchmark, août 2026
- Anthropic, Claude Opus 4.8 System Card, consultée le 6 août 2026
- CNIL, recommandations sur l'intelligence artificielle, consultées le 6 août 2026

Cet article vous a-t-il été utile ?
Votre retour nous aide à améliorer nos contenus.


